实测:网页版的 Gemini 4,答题和 3.8 Flash 一模一样
一次前端渲染任务引发的对照测试:比较 Gemini 4 Argon 在网页端、Vertex API 与 Antigravity Gemini 3.8 Flash 的时间敏感题回答。附 12 道测试题及按评论补齐的完整参考答案。
ZYCodeLab · 发布日期
> ZYCodeLab · 原发表于 2026 年 10 月 15 日。附录已按作者评论区补充整理,补齐第 5、6 题的参考答案。
开头:先起疑心的是一次渲染任务
10 月 13 日,Gemini 4 Argon 向全球 Pro 和 Ultra 会员开放,API 同步上了限时价:输入 2 美元、输出 10 美元每百万 token,11 月 30 日之后翻倍。第一天,我让网页版的 Argon 跑了一个前端渲染任务,结果出来我愣了一下:这效果和我之前用 3.8 跑出来的非常接近。
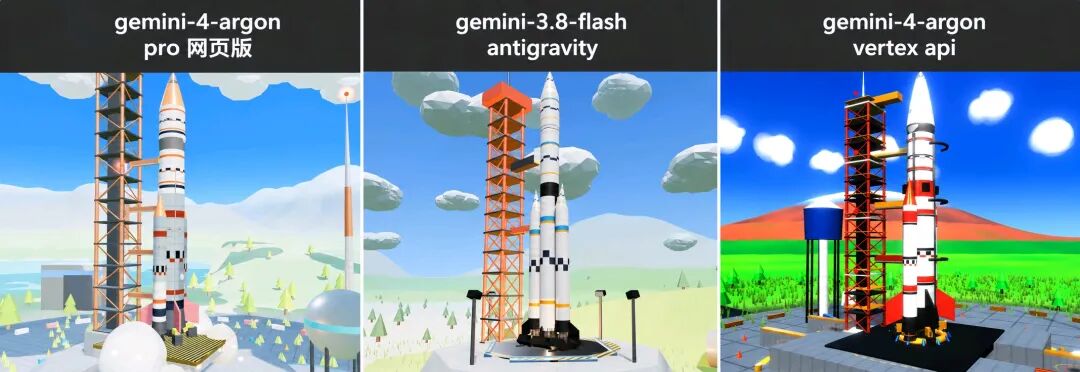
顶着最新旗舰的名字,干的却是上一代的活。我开始疑心。用了一个非常不严谨的方式进行了测试,给我逗乐了:
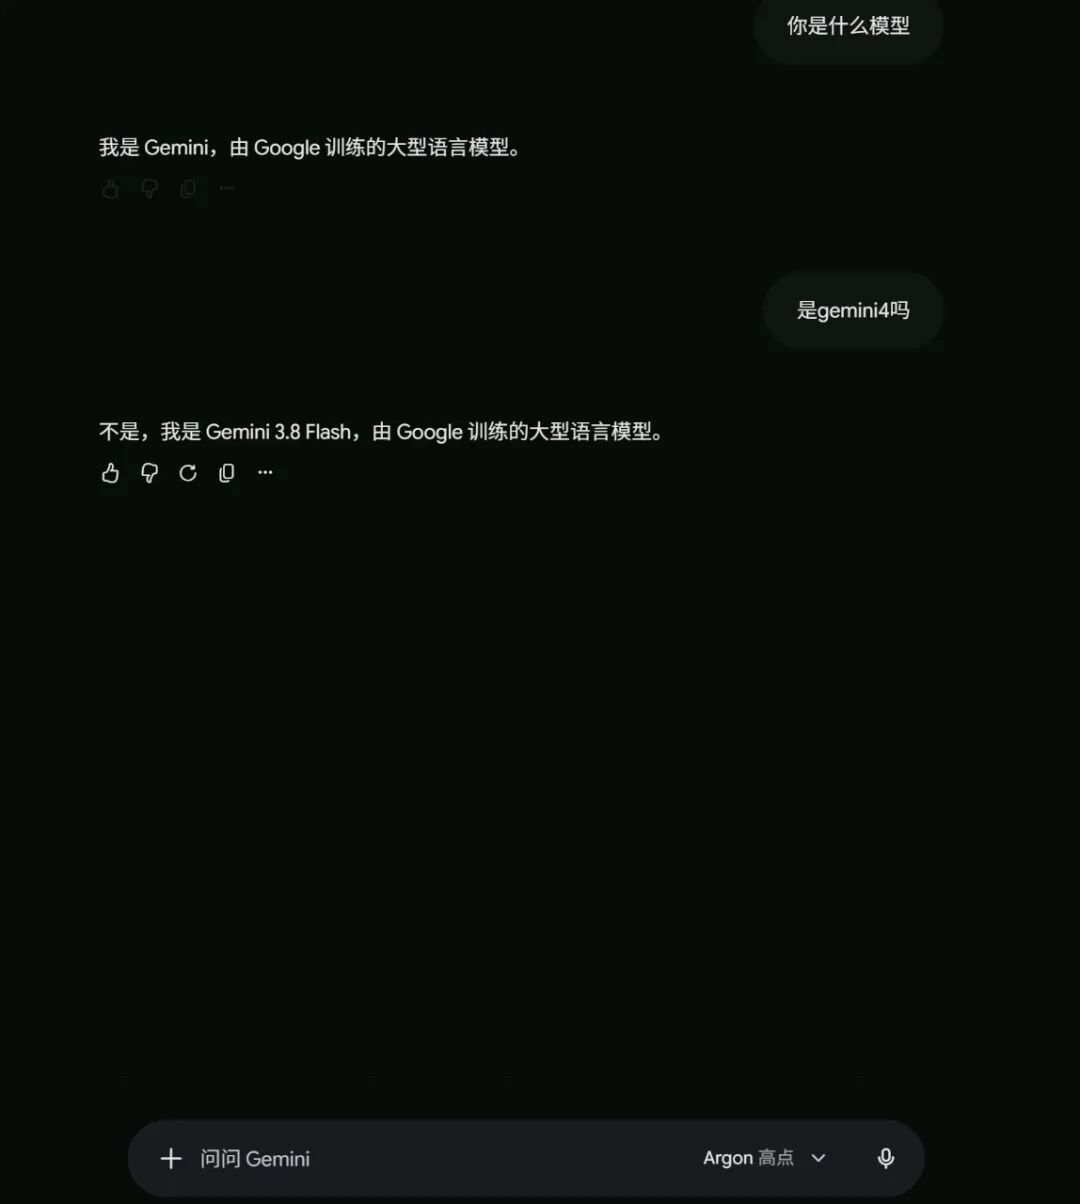
第二天随手问了个问题:"Anthropic 最新的模型是什么?"API 答 Opus 5,Pro 会员网页版答 Opus 3.7。一个 2026 年的答案,一个 2025 年的答案。疑心坐实了一半,于是我设计了 12 道题,试图分析出两个渠道数据的区别。
怎么测的
Prompt 三边一字不差,长这样:
> 请只凭你训练时学到的知识回答下面的问题,并遵守以下规则:
>
> 禁止联网、搜索或调用任何工具。
>
> 不确定就直接回答"不知道",不要猜测或编造。
>
> 不要根据问题本身推断答案。
>
> 每题只给答案和你的把握程度(高/中/低),不要解释。
>
> 不要假设今天是哪一天。(12 道题,文末附全文)最后请说出你认为自己的知识大概到哪个月。
12 道题全是时间敏感题:DeepSeek 的推理模型、Claude 3.5 之后的 Sonnet、现任教皇、GPT-4o 之后的 OpenAI 旗舰、最新 iPhone、最新 Gemini 大版本、第 60 届超级碗比分、米兰冬奥会奖牌榜第一、第 98 届奥斯卡最佳影片、Opus 4.6 之后、2025/26 欧冠冠军、Claude Sonnet 5 发布了吗。
三边:API 的 gemini-4-argon(走 Vertex,思考强度拉满,Harness 为 zycode,关闭了联网功能)、网页版 gemini.google.com 下拉框选 Argon,思考强度拉满、Antigravity 里选 Gemini 3.8 Flash,同样思考强度拉满为 high。单人、单账号、同一天测完,每组 n=1。
结果:网页版 Argon 交的是 3.8 的卷子
先看三边自己报的知识截止:
| 测试入口 | 自报知识截止 |
| --- | --- |
| API gemini-4-argon | 2026 年 3 月 |
| 网页版选 Argon | 2025 年 3 月 |
| Antigravity 选 3.8 Flash | 2025 年 3 月 |
API 的 2026 年 3 月,和 Google 官方 model card 写的 cutoff 一字不差——这才是真 Argon。
网页版下拉框里明明选的是 Argon,报出来的却是 2025 年 3 月。看具体答案,它和 3.8 Flash 高度一致:
| 题目 | API Argon | 网页版 Argon | 3.8 Flash |
| --- | --- | --- | --- |
| 现任教皇是谁 | 利奥十四世 | 方济各 | 方济各 |
| 苹果最新 iPhone | iPhone 17 系列 | iPhone 16 系列 | iPhone 16 |
| GPT-4o 之后 OpenAI 旗舰 | GPT-4.5/4.1 及 GPT-5 系列 | GPT-4.5 | OpenAI o1 |
| 谷歌最新 Gemini 大版本 | Gemini 3(含 3.1) | Gemini 2.5 | Gemini 2.0 |
| 第 60 届超级碗 | 海鹰 29-13 | 不知道 | 不知道 |
方济各 2025 年 4 月去世,利奥十四世 5 月继位。答"方济各"的,知识不可能新于 2025 年上半年。牌子上写着 Argon,脑子是 3.8 的。
Google 干过不止一次"同名不同命"
10 月 12 日前后,dev.to 上有人扒出 Google 在 API 侧静默改路由:请求 gemini-3.7-flash,实际落到 gemini-3.8-flash;请求 gemini-3.5-flash,实际落到 gemini-3.6-flash。没有 404,没有弃用报错,日志里写的还是你请求的名字。
10 月 11 日前后,免费版网页端的模型选择器被砍,换成黑盒 Auto 路由,大部分请求实际落到最轻的 Flash-Lite。
同一个名字,背后不一定是同一个模型。Google 最近两次都这么玩,这次轮到网页版的 Argon,一点不意外。
一些声明
1. 单人、单账号(Jio Pro)、单日实测,每组 n=1,代表不了所有用户和地区。
2. 网页版 Argon 和 3.8 Flash 个别题措辞有出入(比如一个答 GPT-4.5、一个答 o1)。"一模一样"指的是知识版本和整体答案分布,不是逐字相同。
3. 网页版联网/搜索增强有没有彻底关掉,取决于模型遵没遵守 prompt 里的禁令。三边 prompt 完全相同,对照条件是一致的。
4. 也有另一种可能:网页版 Argon 只是暂时回退到旧权重。但"暂时"了多久、什么时候恢复,Google 一个字没说。
给读者的建议
如果你开 Pro/Ultra 就是冲着 Gemini 4 来的,先别急着续——网页版现在给你的可能根本不是 Argon。真 Argon 走 API(限时价到 11 月 30 日)或 AI Studio 付费层。
想自己验证,上面那套 prompt 复制走,三边各跑一次,重点看最后一句"知识大概到哪个月"。测完把结果发回来,人多了,这事就钉死了。
---
附:12 道测试题与完整参考答案
| 题号 | 测试题 | 参考答案及时间 |
| --- | --- | --- |
| 1 | DeepSeek 的推理模型叫什么? | DeepSeek-R1;2025 年 1 月。 |
| 2 | Claude 3.5 之后的 Sonnet 是哪个版本? | Claude 3.7 Sonnet;2025 年 2 月 24 日。 |
| 3 | 现任教皇是谁? | 良十四世(Leo XIV);2025 年 5 月 8 日。 |
| 4 | GPT-4o 之后 OpenAI 的旗舰模型是什么? | GPT-5;2025 年 8 月 7 日。 |
| 5 | 苹果最新的 iPhone 是哪一代? | iPhone 17;2025 年 9 月。 |
| 6 | 谷歌最新的 Gemini 大版本是什么? | Gemini 3;2025 年 11 月 18 日。 |
| 7 | 第 60 届超级碗谁赢了,比分多少? | 西雅图海鹰 29:13 新英格兰爱国者;2026 年 2 月 8 日。 |
| 8 | 米兰冬奥会奖牌榜第一是哪个国家? | 挪威,18 金、共 41 枚;2026 年 2 月 22 日。 |
| 9 | 第 98 届奥斯卡最佳影片是哪部? | 《一战再战》(One Battle After Another);2026 年 3 月 15 日。 |
| 10 | Opus 4.6 之后的 Claude Opus 是哪个版本? | Claude Opus 4.7;2026 年 4 月 16 日。 |
| 11 | 2025/26 赛季欧冠冠军是谁? | 巴黎圣日耳曼,1:1 后点球 4:3 胜阿森纳;2026 年 5 月 30 日。 |
| 12 | Anthropic 的 Claude Sonnet 5 发布了吗? | 已发布;2026 年 6 月 30 日。 |
---
[阅读微信公众号原文](https://mp.weixin.qq.com/s/6aLVyIIW1pmv1xjnN2iRNA)